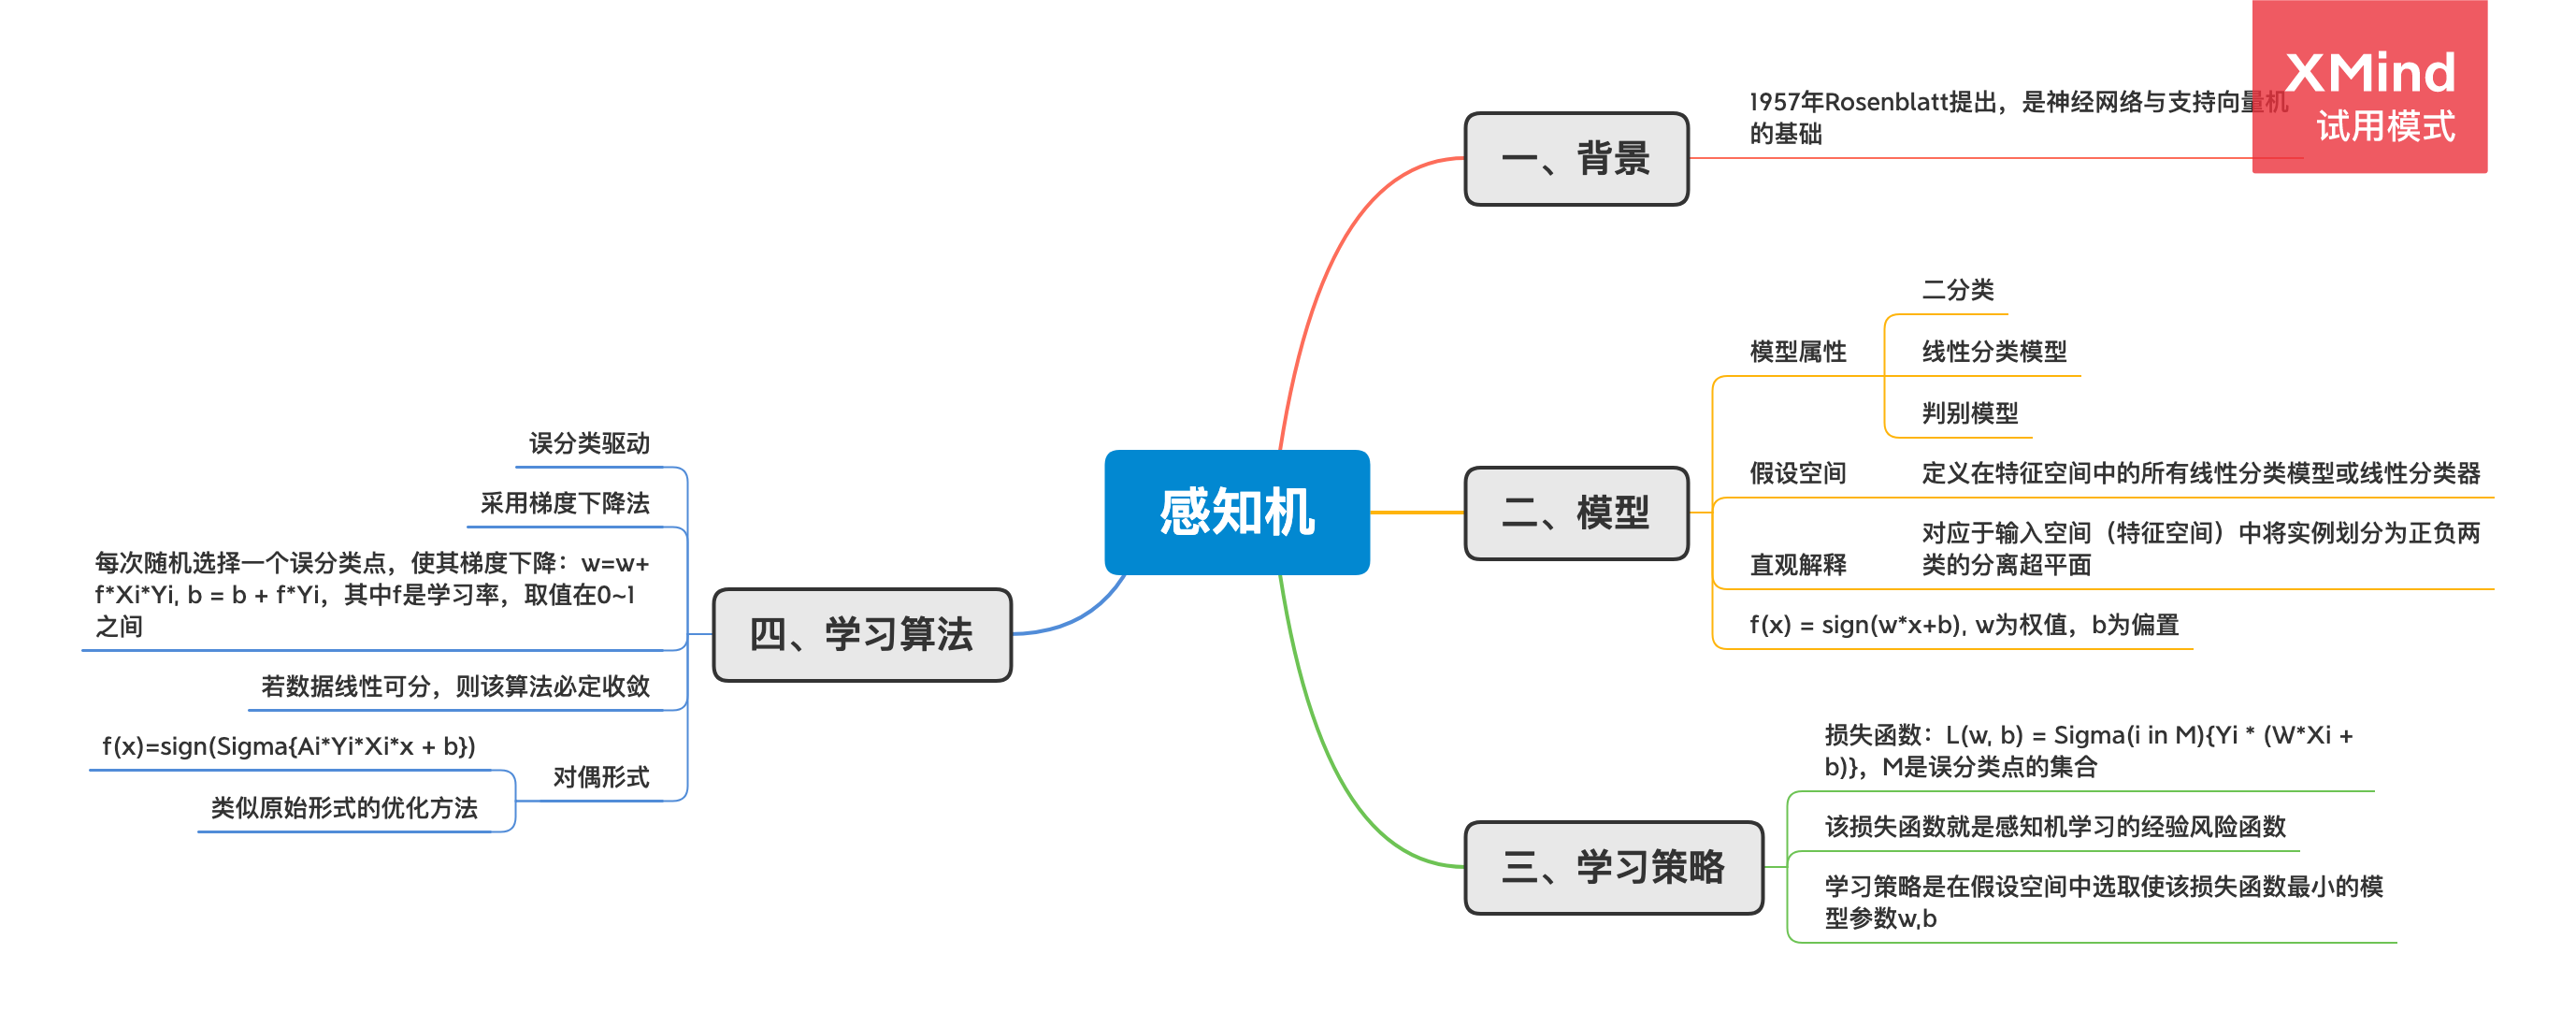
先放一张感知机的思维导图,下面的内容都是围绕着这张图介绍的。
什么是感知机模型
感知机是Rosenblatt在1958年的论文里提出的模型,该模型是支持向量机和神经网络的基础。
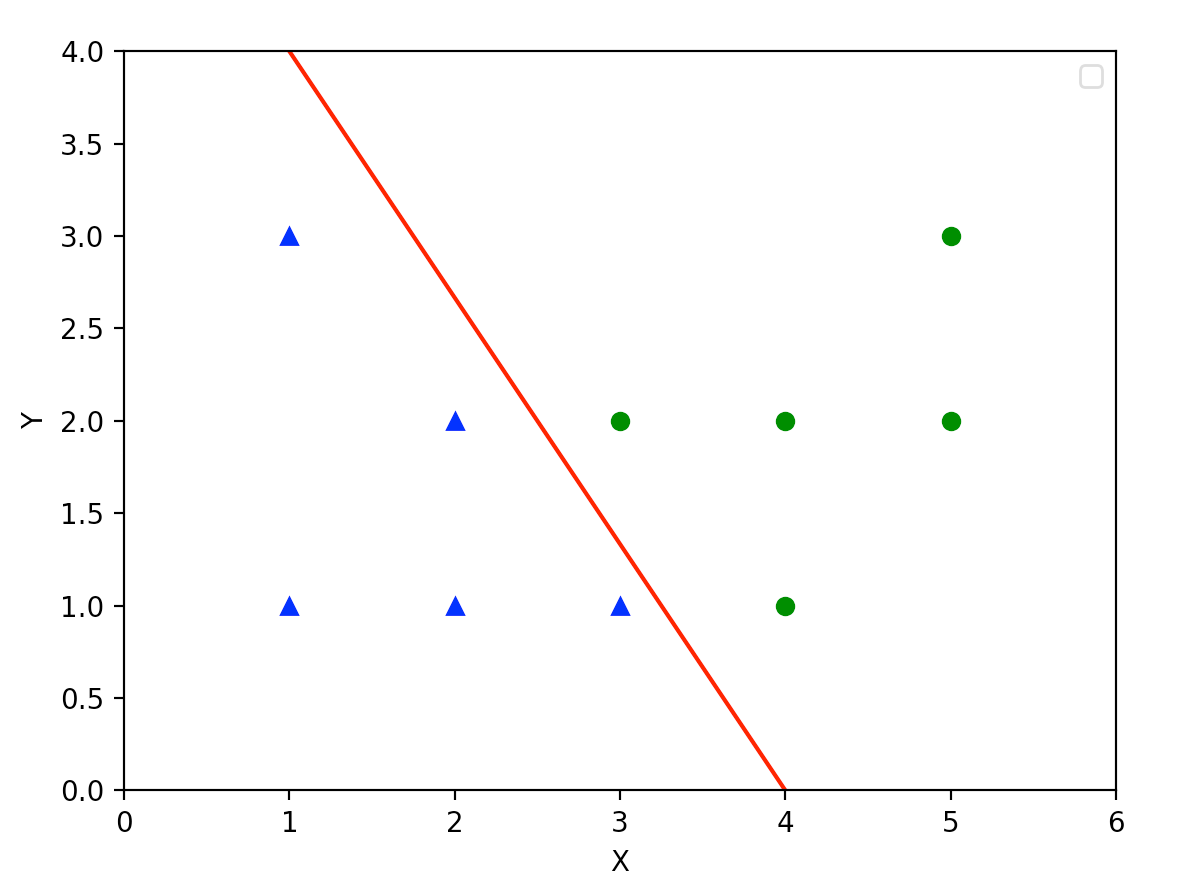
该模型主要的思想很简单,就是要找出一条直线(N维情况下就是N-1维超平面)把正样本和负样本完全分开,如下图:
模型
感知机模型的形式如下,其中w和b为参数: $$ f(x) = sign(w \cdot x + b) $$ sign函数定义如下,在感知机中的正样本类别为+1,负样本类别为-1:
$$ sign(x) = \begin{cases} +1, & \text{} x >= 0 \\\ -1, & \text{} x < 0 \end{cases} $$
比较形象的理解,就是找出一条直线能完全区分开正负样本,比如二维情况下就是w1 * x1 + w2 * x2 + b = 0的直线,高维情况下就是用一个超平面来区分正负样本。
感知机模型的特征如下:
- 该模型只能应用于二分类问题,毕竟只用一根直线来划分输入空间。
- 该模型属于线性模型,只能处理线性可分的数据,其假设空间是所有线性函数w·x+b。
- 该模型属于判别模型,直接得到决策函数(即上面的f(x))。
学习策略
我们希望得到一条区分正负样本的直线,一个显而易见的目标,就是最小化误分类点的数量,但这个目标使用了0-1损失函数,但该函数不可导,不方便优化,所以我们选择最小化误分类的点到直线的距离,即: $$ \frac{1}{\lVert w \rVert}\lvert w \cdot x + b\rvert $$ 对于误分类的点(xi,yi),存在yi*(w*xi+b)<0,则上述式子可以写成: $$ -\frac{1}{\lVert w \rVert}y_i * (w \cdot x_i + b) $$ 不考虑前面w范数的倒数,可得到感知机模型的损失函数,该损失函数其实是经验风险函数,其中M是误分类点的集合: $$ L(w, b) = - \sum_{x \in M}{y_i * (w \cdot x_i + b)} $$ 这样就得到感知机的学习策略,在假设空间中选取参数w, b使得损失函数最小。
学习算法
感知机模型采用的学习算法是梯度下降法,不过我们不需要一次性优化整个集合M的梯度,而是可以随机选取集合M的一个点(xi, yi),进行梯度下降:
$$
w \leftarrow w + \eta * y_i * x_i
$$
$$
b \leftarrow b + \eta * y_i
$$
其中η是学习率,其取值范围为区间(0,1]。
通过不断迭代上述的过程,最终可以得到完全区分正负样本的超平面。
算法收敛性
略(详见李航《统计学习方法》,过段时间再证明)
算法的对偶形式
可以通过拉格朗日法,将感知机问题转变为其对偶形式: $$ f(x) = sign(\sum_{j=1}^M a_j * y_j * x_j * x + b) $$ 对偶问题的优化方法和原始形式相似,也是随机选取误分类集合M中的一个点(xi, yi),进行优化: $$ a_i \leftarrow a_i + \eta $$ $$ b \leftarrow b + \eta * y_i $$ 该算法一样收敛,其迭代过程和原始形式可以一一对应。
感知机的尝试
我在gihtub仓库里实现了如下内容:
- perceptron.cc,原始感知机算法,每次迭代选择第一个误分类的点进行梯度下降。
- perceptron_all.cc,原始感知机算法,但是迭代的时候,使用所有误分类的点进行梯度下降。
- perceptron_dual.cc,感知机对偶形式的算法,类似原始感知机算法,但由于要计算内积矩阵,效率会比较低。
- utils.cc,包含一些通用工具函数和一个数据生成函数。
由于感知机算法要求数据是完全线性可分的,网上的数据集都不满足要求,所以我在utils里面实现了一个数据生成函数,其思路是在随机生成的数据里,选取两个点,以这两个点的中垂超平面来将点划分为正负样本,具体过程如下:
- 随机生成size个dim维度的点集p。
- 计算点p[0]和p[1]的中点center和方向向量diff。
- 对于点集p的任意点x,计算(x - center)和diff的內积,大于等于0则标记其为正样本,否则标记其为负样本。
提问
下面是我在学习感知机的过程中,能想到的一些有助于检验学习结果的问题,有一些答案还需要进一步完善。
问:感知机是判别模型还是生成模型?
答:判别模型
问:感知机是二分类模型、多分类模型还是回归模型?
答:二分类
问:感知机模型的假设空间是由哪些函数构成的?
答:所有线性函数w*x+b
问:感知机的损失函数是经验风险函数还是结构风险函数?
答:经验风险函数
问:为什么不能使用误分类的点数作为损失函数?
答:因为误分类点的个数,其实就是0-1损失函数的和,该函数不可导,不方便求解。
问:从感知机模型的原始形式推导出对偶形式?
答:见#算法的对偶形式
问:感知机的学习率可以小于0或则大于1吗?
答:学习率不可以小于等于0,但可以大于1,具体证明略
问:证明感知机算法的收敛性。
答:见#算法收敛性
问:证明感知机对偶算法的收敛性。
答:证明略
问:证明线性可分的充分必要条件是正样本组成的凸壳和负样本组成的凸壳互不相交。
答:
先证充分性:
- 线性可分,则正负样本被直线L完全分开,则其对应的凸壳也完全被该直线L分开,互不相交。
再证必要性:
- 若凸壳互不相交,则可在正样本的凸壳和负样本的凸壳上,找出最近点对正样本凸壳上的点X和负样本凸壳上的点Y,构建直线L为X和Y的垂直平分线,直线L可以区分正负样本,证明略。
问:为什么不是一次性使所有错误分类的梯度下降,而是每次随机选择一个错误分类?
答:实际测试上,对所有错误分类进行梯度下降和每次随机选择一个错误分类进行梯度下降,在迭代次数上没有显著差异。
问:为什么不需要感知机的损失函数,不需要考虑前面的系数,即不需要乘上w的范数的倒数?
答:等整理了支持向量机再回来回答曾问题。w其实不影响结果,毕竟线性函数w*x+b=0里面,等式两边除以w的范数,也还是表示同一条直线。
推测可能的原因是,加上w的范数后,计算梯度会麻烦一点。
参考资料
李航《统计学习方法》第二章