什么是knn
knn是Cover和Hart在1968年的论文里提出的分类算法,全名叫K Nearest Neighbor,中文翻译是k近邻算法。
knn的思想很简单,核心假设是同类别的样本在特征空间上的距离较近,但由于数据存在噪声,只找最近的样本会有问题,所以我们综合考虑最近的k个样本。
基于这个思想,knn对每一个样本,会在训练集中找出与该样本距离最接近的k个样本,取这k个样本中出现次数最多的类别作为该样本的分类结果。
用下面的例子来简单介绍一下knn,假设有10个训练数据,如下图,蓝三角形和绿圆形分别表示不同的类别:
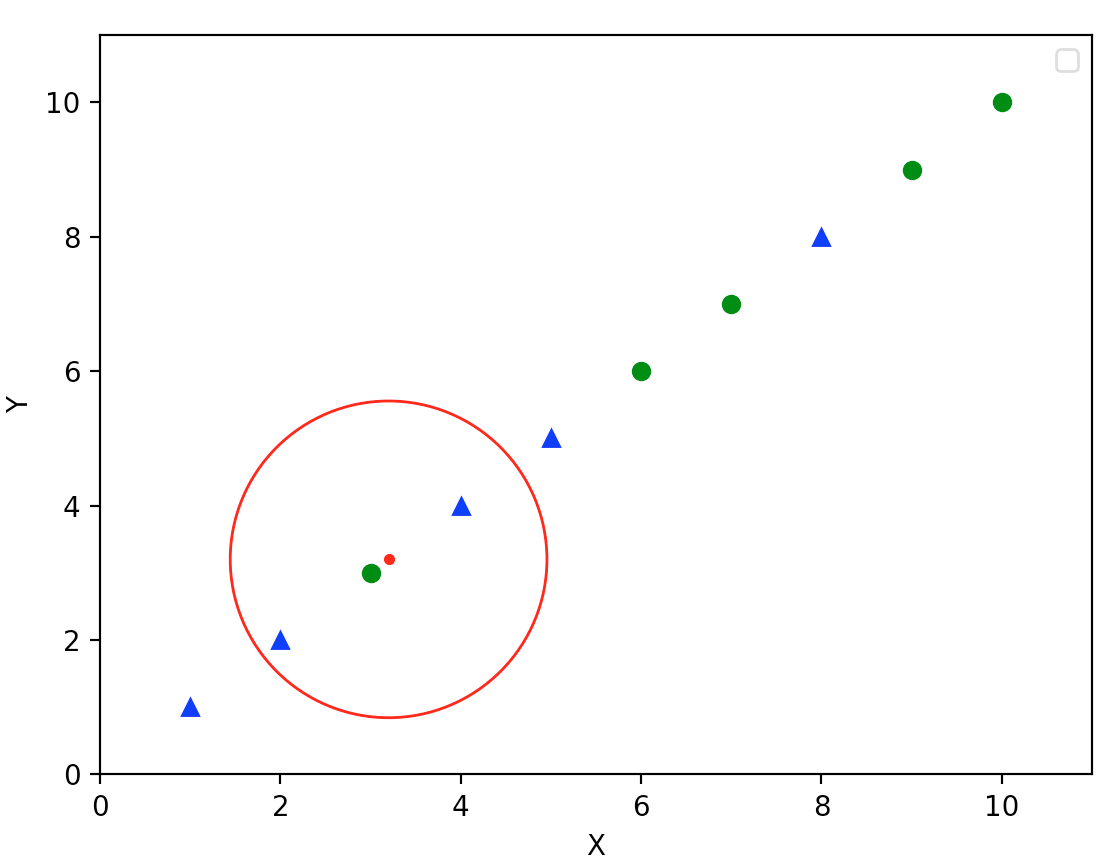
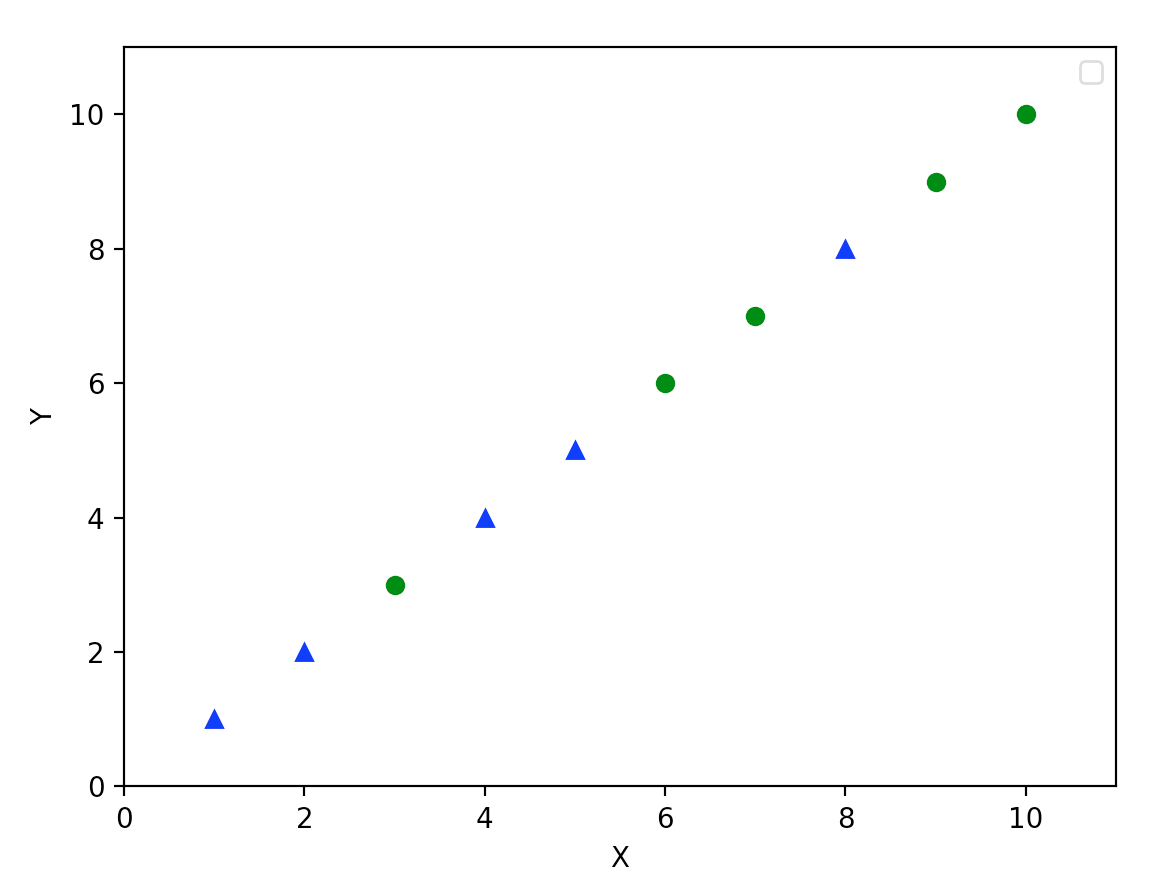 若我们想得到下图红点的类别,假定k为3,则我们在训练样本中找最近的3个样本,即红色圆圈内有的两个蓝三角形和一个绿圆形,于是我们将红点分类红色圆圈内出现次数最多的类别,即蓝三角。
knn有哪些参数
knn的模型主要由下面三个要素决定:
- k值的选择(例子中的k=3)
- 距离度量(例子中使用了欧式距离,所示的红色圆圈)
- 分类决策规则(例子中以多数类别作为分类结果)
k值的选择
k值的选择需要结合具体的应用数据,通常会选用较小的一个值,然后通过交叉验证法来选取最优的k值。
可以从方差和偏差来考虑k值对模型的影响:随着k值的增大,模型的方差会逐渐变小,偏差逐渐变大。
假定k值为1,算法就退化成最近邻,此时模型对数据非常敏感,一旦数据噪声较多,则模型的准确率会很低。
随着k值的增大,模型逐渐降低了数据噪声的干扰,但分类的结果会逐渐倾向于整体数据。
当k值为N时,则将永远返回数据中占比最多的分类,此时方差为0。
这里有一篇文章,以knn为例讲解了偏差和方差的区别,可以看看。
距离度量
在数学上有对于距离度量的严谨定义,这里就不详细说了。
常见的距离度量,主要是曼哈顿距离、欧式距离(knn最常用的距离)和切比雪夫距离。
对于维度为N的x和y向量,各个距离的公式如下:
曼哈顿距离 $$ L_1 = \sum_{i=1}^N|X_i - Y_i| $$
欧式距离 $$ L_2 = \Bigg(\sum_{i=1}^N{(X_i - Y_i)^{2}}\Biggr)^{\tfrac{1}{2}} $$
切比雪夫距离 $$ L_\infty = \max_i|X_i - Y_i| $$
分类决策规则
knn的分类决策规则往往是多数表决,由距离最近的k个样本的多数类决定测试样本的类别。多数表决规则其实等价于经验风险最小化。
其实还有其他方案,比如将这k个样本按照距离进行平均或则加权平均(该规则也能在回归任务上)等等。
knn有哪些实现
knn算法的难点是如何快速在训练集里找到距离前k小的样本,最简单的实现是线性扫描,对于测试样本,计算该样本到所有训练样本的距离,排序取前k个。
另外一种常见的实现方法是采用kd树,这里就不展开介绍了,可以参考这个文章。 在数据随机且维度不大的情况下,kd树的复杂度会优于线性扫描,但如果维度接近于样本数量,则kd树约等于线性扫描。
knn的优缺点
k近邻算法的优点如下:
- 实现简单
- 没有显式的训练过程
- 精度高(根据knn的论文,knn的泛化错误率不超过贝叶斯最优分类器的错误率的两倍)
- 具有可解释性
- 对异常值不敏感
- 无数据输入假定
k近邻算法的缺点如下:
- 计算复杂度高
- 空间复杂度高
归一化
knn使用的是欧式距离,欧式距离对数据的尺度很敏感,比如下面的例子:
假定身高的单位为米,体重的单位为克,很明显这两者在尺度上就有巨大的差异。
此时一个1.7m,60kg的样本和1.0m,60kg的样本的距离为0.7,而1.7m,60kg的样本和1.7m,59kg的样本的距离却高达1000。
若我们是在做大人或小孩的分类,则这样的距离计算会很影响knn的性能。
在大多数情况下,我们都不希望由于特征的尺度不同,而导致其对距离的贡献不一,比如上面例子中,身高的特征即使差异很大,也几乎不影响距离的计算。 为了解决这种问题,我们在使用knn的时候(或则其他和距离尺度相关的算法),我们常常会使用下面的归一化方法来处理数据。
min-max归一化,需要对每一个特征计算min和max。 $$ m = \frac{(x - x_{min})}{(x_{max} - x_{min})} $$
z-score归一化,需要对每一个特征计算均值和标准差。 $$ z = (x - \mu) / \sigma $$
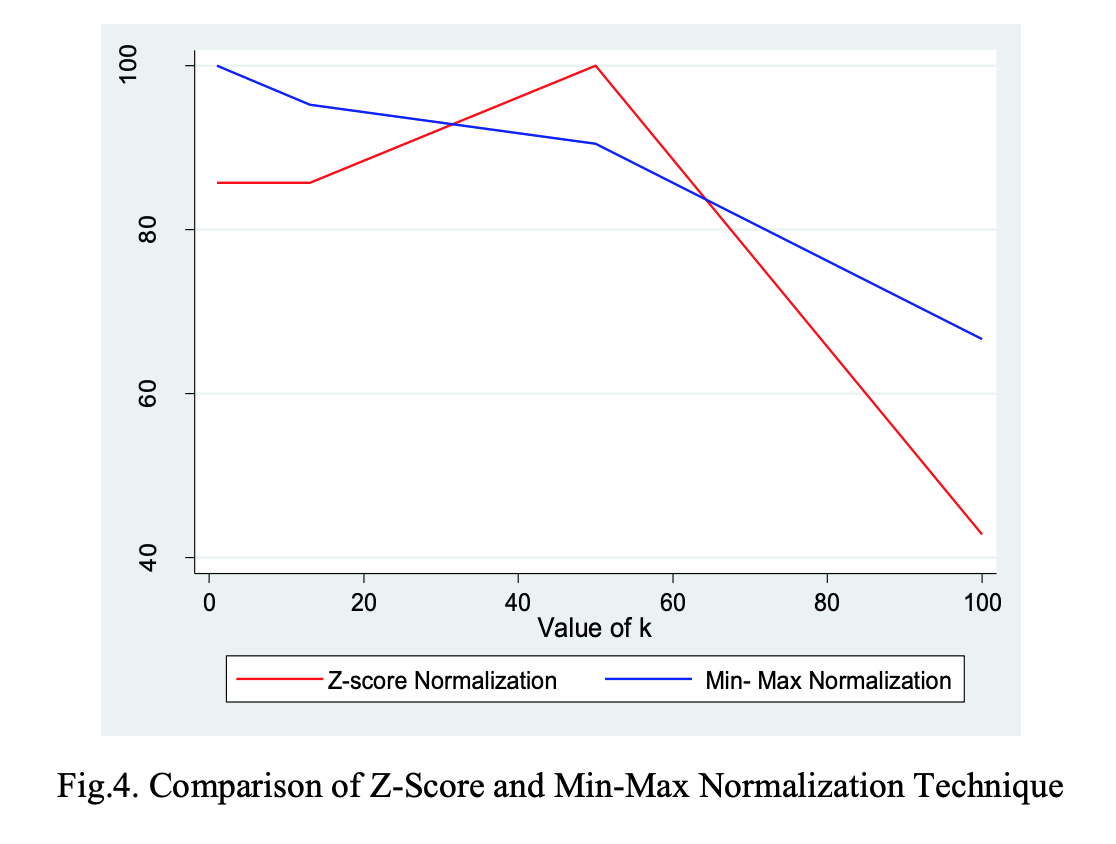
当我在尝试knn算法的时候,也很好奇这两种归一化算法的优劣,然后就搜到了这篇论文。
从论文里给出的对比效果来看,似乎min-max的要比z-score略好一点:
knn的尝试
我在gihtub仓库里实现了knn的线性扫描版本和kd树版本,拿mnist和鸢尾花卉数据集来评估knn的性能。
结果发现knn的算法虽然简单,但效果确实还挺好,mnist的准确率有94%以上,鸢尾花卉的准确率也有93%(正确分类42个/总数45个)。
此外我也在鸢尾花卉数据集上尝试对特征进行归一化,用min-max归一化算法后准确率达到95%(43/45),用z-score归一化后准确率达到98%(44/45)。
但knn有一个显著的问题,就是运行效率低,特别是在mnist数据集上,1w的测试数据,6w的训练数据,特征数量有28 * 28=784个。
如果用线性扫描法,则总的运算量达到1w * 6w * 784,假设计算机每秒运算量为10的8次方,也需要4707秒,超过一个小时。
尝试用kd树来优化knn,结果其性能反而比线性扫描还差。
如果想针对knn的效率问题进行优化,之后可以尝试一下非精确的knn算法,或则是对数据进行降维。
参考资料
机器学习实战 第二章 k-近邻算法
机器学习 第十章 降维与度量学习
统计学习方法 第三章 k近邻法
特征工程入门与实践 第三章 特征增强:清洗数据 - 3.3 标准化和归一化
Nearest Neighbor Pattern Classification
Understanding the Bias-Variance Tradeoff
Comparative Analysis of KNN Algorithm using Various Normalization Techniques
k-d tree算法详解。